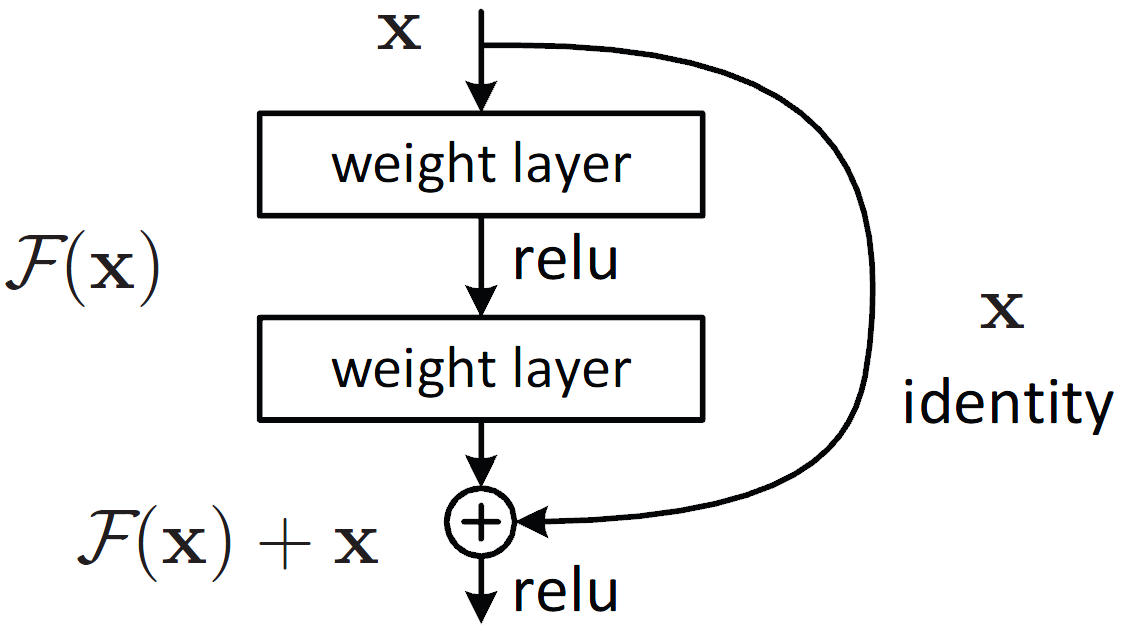
在计算机视觉的深度学习史上,2015 年是一道很清晰的坎。微软亚洲研究院何恺明、张祥雨、任少卿、孙剑的论文《Deep Residual Learning for Image Recognition》,把“网络越深越好训吗”这个问题从口号变成可检验的实验,并给出后来几乎成为默认零件的答案:残差学习与恒等捷径。今天咱们按原文的问题意识来讲:它到底看见了什么病,开了什么药,又明确没有承诺什么。
一、四位作者与时代背景
论文作者为 Kaiming He(何恺明)、Xiangyu Zhang(张祥雨)、Shaoqing Ren(任少卿)、Jian Sun(孙剑),单位为 Microsoft Research。当时视觉识别正沿 VGG 等路线把卷积网堆得更深,人们普遍期待“更深的层级特征”带来更高精度。可训练中出现一个刺眼现象:深度加上去以后,训练误差反而可能变差——不是简单的过拟合故事能够打发。作者在 ImageNet 上把残差网络推到 152 层,并在 ILSVRC 2015 分类等任务取得领先;残差块随后进入检测、分割等大量系统。讲“起源”,应以这篇论文的设定与证据为准,不宜把后世一切带跳跃连接的网络都算进 2015 年的原主张。
二、退化问题:优化失败,不是一句“梯度消失”就能概括
作者把核心困难称为退化(degradation):网络变深后,训练误差与测试误差都可能升高。关键在于,即便使用批归一化等有助于稳定梯度尺度的技术,退化仍可能出现。因此,把它简化成“就是梯度消失没治好”,并不准确。
一个有力的思想实验是:在已经训练好的浅网后面,接上若干恒等映射层,理论上存在一个与浅网表现相当的深网解。如果优化过程找不到这类解,训练误差反而上升,就说明“加层”本身并不自动保证可优化性。ResNet 要做的,正是让“接近恒等”的解在优化景观里更容易被走到。
三、残差形式:让层去学“要改多少”,而不是“整段重造”
记期望的底层映射为 $\mathcal{H}(x)$。残差学习不直接逼堆叠非线性去拟合 $\mathcal{H}$,而让它们拟合
$$\mathcal{F}(x):=\mathcal{H}(x)-x$$
于是
$$\mathcal{H}(x)=\mathcal{F}(x)+x$$
作者的工作假设是:残差映射往往比无参照的原映射更好优化;若最优接近恒等,把残差推近零,通常比用一串非线性硬凑恒等更顺。实现上,捷径把 $x$ 加到堆叠层输出:维度一致时用恒等捷径(不加参数、不加计算负担),不一致时用投影捷径。整个网络仍可用常规反向传播端到端训练。
ImageNet 实验里,残差网在显著更深时仍可优化,并获得精度收益;CIFAR 上也有对极深网络的分析。这些是“在作者设定下更深仍可训、且能受益于深度”的证据,不是对任意任务的空白支票。
四、它缓解了什么,又没有保证什么?
残差连接提供了较短的前向/反向路径,经验上常改善深层训练。但必须把话说死、说完整:
- 不是“梯度从此永不消失”的定理保证。梯度是否健康,还取决于激活函数、初始化、归一化、损失形状、数据与优化器。
- 不是对所有模态、所有深度的无条件最优结构;后续 DenseNet、各种归一化与注意力块,都在不同权衡下继续改写工具箱。
- 论文主要论证:在对照实验中,残差网比同等深度的普通堆叠网更易优化,并能从增加深度中获得精度。
把 ResNet 缩成一句“跳连治百病”,会害读者;把它理解成“改变要学习的目标形态,并给优化器一条更容易的恒等旁路”,更贴近原文。
五、和 Neural ODE、Transformer 怎么划界
有人把 $x_{t+1}=x_t+f(x_t)$ 看成欧拉法一步,连续极限通向 Neural ODE——这是富启发的后验视角与新模型路线,并不等于 2015 年 ResNet 论文已经在做连续深度网络。Transformer 层内也大量使用残差,那是“加性捷径”在序列模型里的迁移,注意力机制本身回答的是交互与并行问题。三章分开,才不会把三条线索捏成一个神话。
六、恒等捷径的工程细节:何时要投影?
当残差分支与捷径的特征图尺寸或通道数不一致(例如下采样、通道加倍)时,单纯的 $x$ 无法直接相加。论文讨论用线性投影(convolution $1\\times1$ 等)把 $x$ 映射到同维,再相加。恒等捷径零参数的优点在匹配维度时最干净;投影捷径引入少量参数与计算,换来结构灵活性。阅读实现或复现时,先核对每个 stage 的下采样位置与通道变化,否则容易把“加不起来”误当成理论失败。
七、退化曲线怎么读(不背具体百分比也能抓住方法)
作者用“同样层数的普通堆叠网 vs 残差网”的训练曲线对照,展示残差网随深度增加仍可继续优化,而普通深网出现退化。科普转述时,请避免脱离图表上下文背诵单个误差数字;更重要的是方法:控制深度变量、观察训练误差是否不降反升、检验是否存在接近恒等的构造解。自己画一张“深度—训练误差”草图,比记住某年竞赛名次更有助于理解。
八、常见误解
- 误解:ResNet 证明梯度消失被彻底消灭。更正:它针对退化/优化问题提出残差框架;梯度健康仍依赖整体训练配方。
- 误解:捷径等于不用学。更正:残差支路仍要学 $F$;捷径提供参照,不取消学习。
- 误解:所有 skip connection 都叫 ResNet。更正:跳跃连接有多种家族;ResNet 特指残差学习框架及其论文设定。
- 误解:更深永远更好。更正:残差使更深更可训,但收益受数据、正则、计算预算与任务饱和限制。
九、为何它配得上“起源”这一章
因为此后大量视觉骨干默认假设“块内可以加残差”,检测与分割系统也建立在深层可训的骨干上。起源的意义,不在于神化一篇论文,而在于看清问题是如何被定义的:不是抽象地喊“更深”,而是把退化变成可观测现象,再给出改变优化目标形态的结构。读完本章,建议带着“残差是离散欧拉一步吗?”这个问题去读首页 Neural ODE——你会看到启发如何变成新模型,以及新模型又如何必须重新交代误差与记忆。
核对请回到何恺明等 arXiv:1512.03385 的第 3 节公式与第 4 节实验;GitHub 说明页可帮助对照 ILSVRC/COCO 提交使用的模型配置。本站插图为教学示意,不是论文原图复制。
十、残差块里的非线性放哪里?
经典基本块常采用“卷积—激活—卷积”,再与捷径相加,相加后通常再跟激活(具体变体随实现略有差异)。后来的预激活(pre-activation)残差块把归一化与激活挪到权重层之前,进一步改善极深网络训练,那是后续论文的贡献,不应倒写成 2015 原文的唯一形态。阅读代码时先确认你复现的是“原版基本块/瓶颈块”还是“预激活变体”。
瓶颈块(bottleneck)用 $1\\times1$ 降维、 $3\\times3$、再 $1\\times1$ 升维,以控制极深网络的计算量;ImageNet 上的 ResNet-50/101/152 多用此类结构。基本块则在较浅 ResNet-18/34 更常见。结构选择是计算—精度权衡,不是道德问题。
若把残差输出写成 $x + F(x)$,反向传播时对 $x$ 的梯度含有“直通项”与“经过 $F$ 的项”。直通项有助于缓解某些深层信号衰减,但这仍是直觉级说明,完整行为要结合具体激活与归一化分析。这也是我们拒绝写“永不消失”的原因:数学上更负责的说法是“提供了一条加性通路,改善了许多实践中的优化表现”。
十一、从 ImageNet 分类到检测分割:为何骨干变了生态就变了
当分类骨干变得又深又可训,检测与分割系统可以在其上提取更丰富的层级特征。作者团队在 ILSVRC 与 COCO 相关任务上的成绩,展示了残差表征的迁移价值。这不等于“只要换 ResNet 一切上涨”:检测头设计、多尺度特征、训练日程同样关键。但没有可训的深层骨干,许多后续架构讨论会缺少共同底座。
对初学者,一个可操作的练习是:在标准库中加载 ResNet-18 与去掉捷径的对照浅层网(若你能改模型),在小数据集上看训练曲线差异;或至少阅读框架文档里 residual block 的实现,对照 $y=F(x)+x$。动手一次,比只看竞赛新闻更接近论文精神。
小结:ResNet 把退化问题推到台前,用残差学习与恒等捷径让深度重新可买;它改善优化,不颁发“梯度永生”证书。带着这个分寸,再去读连续深度与注意力章节,会稳很多。
再补一个阅读坐标:ResNet 之前的高速路网络(Highway Networks)等也探讨了门控捷径;ResNet 的恒等捷径以更简洁的形式大范围流行。比较不同捷径家族时,请分别打开原论文看门控是否可学习、是否有额外参数、实验对照是什么,避免在名词上打架。